Mostrando entradas con la etiqueta SEBiBC. Mostrar todas las entradas

24 de octubre de 2025

Jornadas de Bioinformática JBI2025

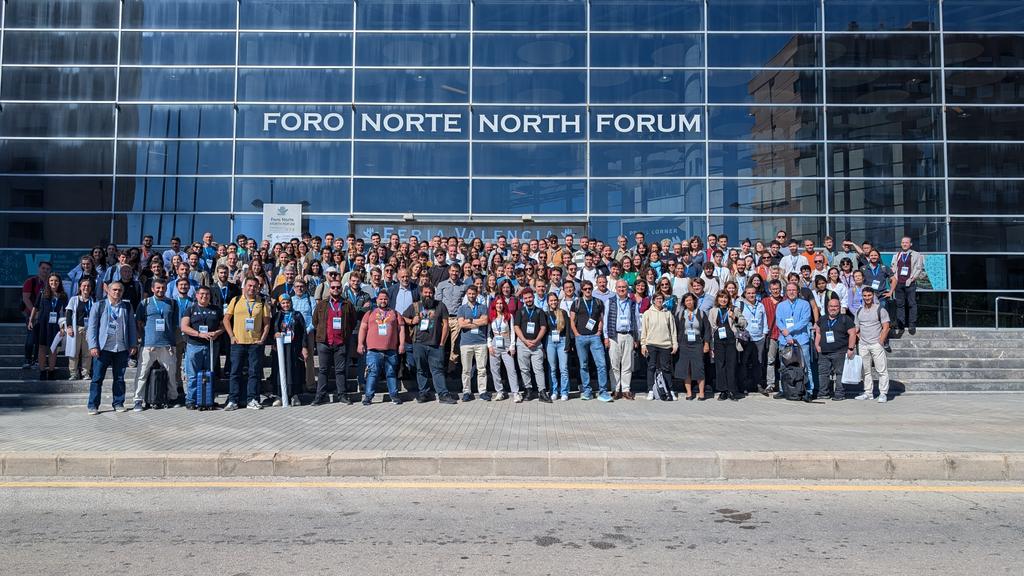
Hola, estos días hemos estado en las JBI2015 en Madrid, en la Escuela de Ingenieros Industriales, más de 300 personas. Tras el 1er congreso de la SEBiBC el año pasado teníamos ganas de más. La verdad es que lo pasé muy bien y disfruté de volver a ver a tantos colegas de ruta. Ya sabemos que el siguiente congreso será el 2o de la SEBiBC el 11-13 de noviembre de 2026. 

Por parte de nuestro labo fuimos Joan Sàrria y yo con dos pósters:

Dejo aquí mis notas de las charlas y pósters que pude atender, mezclando inglés y español.

Roser Tormo (Sanger Institute) talks about cell genomics with a focus on the female reproductive system, see bioinfoperl.blogspot.com/2024/10/notas-1er-congreso-SEBiBC.html. Quieren reconstruir el proceso de foliculogénesis en el labo e identificar los principales TFs y enhancers que controlan el ciclo.

Mikel Hernáez (CAM-UNAV) "Uncovering Functional IncRNAs by scRNA-se with ELATUS". Cuenta que pseudoalineamientos son más sensibles que mapeos por alineamiento para cuantificar lncRNAs (kallisto > salmon > STAR > Cell Ranger). Programan ELATUS partiendo de Kallisto, que en modo single-cell descarta los multimapeos, pero tiene más FP que Cell Ranger; artículo: https://doi.org/10.1038/s41467-024-54005-7

Carolina Monzó (I2SysBio-CSIC) "Quality assessment of long read data in multisample lrRNA-seq experiments with SQANTI-reads". Good quality human transcriptome, 73% of known transcripts, 19% novel, with higher depth providing more unknown exon junctions. After tests in several species they still cannot figure the min depth to saturate transcript models. Artículo: https://doi.org/10.1101/gr.280021.124

Daniel López-López (FPS) "The Spanish Polygenic Score (PGS) reference distribution: a resource for personalized medicine". Imputan y asignan fase de variantes en 2.2K muestras. Artículo: https://doi.org/10.1038/s41431-025-01850-9. PGS se están usando en mejora también para calcular breeding values.

Jacob Fernández Isa en su póster usa aritmética de kmeros (https://github.com/refresh-bio/KMC) para definir marcadores centroméricos y detectar recombinación en polen. 

Graciela Uria, (IIS-FJD, UAM) Dissecting the functional landscape of rare diseases.  They identify new pathogenic variants which are validated by segregation analysis on pacient pedigree data.

Raquel Blanco Martinez-Illescas (IRB) "Sex and smoking influence the clonal structure of the normal human bladder". Charla preciosa, que le valdría el premio a mejor presentación, donde mostraba cómo descubrió 4 genes que explican porqué los hombres y fumadores tienen más prevalencia de cáncer de vejiga. Se trata en realidad de selección natural a nivel de tejido, y de genes que evolucionan más rápido. El artículo es https://pubmed.ncbi.nlm.nih.gov/41062697

Tim Hubbard. Charla larga, resume su perspectiva de cómo las cosas están cambiando en bioinformática con el ejemplo de los servicios de ELIXIR (visibility, robustness, ease of use) y cómo ahora, además de datos generados en la investigación tenemos cada vez acceso a datos que se obtienen de manera rutinaria en el día a día.


Pablo Villoslada-Blanco (CNIO) "Virome Shifts in Pancreatic Ductal Adenocarcinoma: New Insights from Untargeted Metagenomics". In phaeces and saliva 5% reads are viruses, with 98% being phages that target particular bacteria taxa (lore specific than antibiotics). So far only DNA sequenced, not RNA.

Alberto Pascual García (CNB-CSIC) "Novel computational tools for high-throughput design and analysis of microbial consortia". Diapos con beamer latex. Tratan de modelar el metabolismo de comunidades bacterianas definiendo gremios. Hacen reacciones con bacterias en vez de enzimas. Las comunidades son mejores que cepas a la hora de expandir nichos. La idea es diseñar comunidades. Faltan experimentos y modelos metabolicos con estequiometria, transportadores no anotados. Código: https://github.com/sirno/misosoup. Artículo más reciente: https://doi.org/10.1038/s41467-025-57591-2

Adrián López-García, (CBGP UPM, INIA-CSIC) "Beyond taxonomy: global patterns of gene family abundances reveal functional ecological drivers in soil microbiomes". Prueban deep homolog clustering (de A Rodríguez del Río)  para asignar funciones a ORFs. Usan datos de un estudio previo. Encuentran muchas familias de genes sin anotar que se asocian a características del suelo (humedad, acidez y mat org).

Daniel Rico (CABIMER) "Evolutionary analysis of gene ages across TADs associates chromatin topology with whole-genome duplications". Looking at vertebrates mostly, discovered TADs encompass genes of similar age. Gene age is measured using WGDs. Old TADs are more expressed, essential and stable across tissues. Artículo: https://doi.org/10.1016/j.celrep.2024.113895

Coral del Val (UGR) "Gene expression networks regulated by human personality". Found core regulatory module in brain, with 3 mammal miRNAs, that are associated to personality. They use blood RNAseq data intersected with brain atlas. Encuentran indicios de molecular condensates como en orgánulos. They work with sets if personality, with genetics explaining over 60%. 

Sonia Tarazona (UPV) "MORE interpretable multi-omic regulatory networks to characterise phenotypes". Produce resultados fáciles de interpretar, usan análisis multivariante interpretable, no AI. El algoritmo PLS es el más equiilibrado en simulación, puedes poner o no datos previos (vínculos de regulación conocidos, pero eso de momento significa que posibles interacciones desconocidas no se descubrirán). Usan expresión génica como target value, el resto de ómics para modelarla. Encuentran hubs y global regulators. Sus datos son vectores de números y datos categóricos.
https://doi.org/10.1093/bib/bbaf270 y https://www.biorxiv.org/content/10.1101/421834v3


Andreia Salvador (UMinho) presenta "MOSCA 2.0: A bioinformatics framework for metagenomics, metatranscriptomics and metaproteomics data analysis and visualization" y de paso https://github.com/iquasere/KEGGCharter , muy descargadas en bioconda.

Cedric Notredame  (CRG) da una conferencia sobre "Feeding Hungry AI with Evolution-Augmented Data: Alignments, Phylogenies, and Next Gen Pipelines". En realidad habla de dos cosas: i) agregar información evolutiva (y estructural) mejora los alineamientos múltiples de secuencias (MSA). Da como ejemplo los resultados de Alphafold > ESMfold y luego muestra cómo los algoritmos de MSA escalan mal y se atragantan con los volúmenes de secuencia actuales, razón por la que en colaboración con colegas polacos han desarrollado https://github.com/refresh-bio/FAMSA. Muestra también varios ejemplos de cómo conocer la estructura 3D de las proteínas ayuda estimar con más precisión las distancias entre ellas (filogenias) dado que la estructura está más conservada y tarda más en saturar que las secuencias, definiendo la twilight zone. Menciona muy de pasada que en trabajo con MSA ahora están usando embeddings (inmersiones en español), mejores que la identidad de secuencia para predecir proteínas que reconocen moléculas de ARN. Más en general, habla con mucho entusiasmo de cómo la IA ha convertido los datos en aditivos de manera que todos los que vayamos generando mejorarán las predicciones futuros y pone como ejemplo central AlphaFold. Desde ahora ya podemos decir que necesitamos más datos de verdad, porque se ha demostrado en este y otros problemas que grandes cantidades de datos permiten resolver problemas irresolubles. Finalmente, habla un buen rato de cómo para calcular grandes volúmenes de datos en su labo inventaron https://www.nextflow.io, que se ha acabdo convirtiendo en el entorno de producción de instituciones como Sanger o el EBI por asegurar reproducibilidad. Ahora es el editor jefe de https://academic.oup.com/journals/pages/nar_genomics_and_bioinformatics e invita a que enviemos artículos sobre protocolos reproducibles. Le preguntan si creen, como T Hubbard, si abandonaremos la línea de comando para hacer programación gráfica; contesta con alusiones a Access, donde era imposible hacer dos veces lo mismo con tantos clicks, y termina diciendo que para obtener procedimientos reproducibles seguiremos usando comando en texto. 


Hasta pronto!


29 de diciembre de 2024

Redes de la bioinformática en España, versión 2024

Hola, antes de que termine 2024 quería recordar las redes que tenemos en España para comunicarnos y colaborar con colegas de profesión y jóvenes investigadores en diferentes momentos de su carrera. Espero esta información sea útil, feliz año!

  • El Instituto Nacional de Bioinformática (INB), que ha organizado desde el principio las Jornadas de Bioinformática que han ido pasando por varios puntos de la geografía. Las de 2025 serán en octubre en Madrid y será ibérica, organizada con colegas de Portugal. Actualmente agrupa a diferentes grupos de investigación que producen software que forma parte del catálogo que ofrece el nodo ES de ELIXIR y su sede está en el Centro Nacional de Supercomputación (BCS). Escribí sobre el evento All Hands de ELIXIR aquí.
  • La Sociedad Española de Bioinformática y Biología Computacional (SEBiBC), constituida en 2020 con la misión de integrar profesionales, sociedades y asociaciones científicas relacionadas con la Bioinformática y la Biología Computacional, con el objeto de representar a este colectivo, promover sus logros y determinar y defender sus intereses. Organizó su primer congreso nacional en octubre de 2024 en Valencia, como contamos aquí, y alternará cada dos años con el INB.
  • La conexión BCB del CSIC, una red "para el establecimiento de conexiones estables entre investigadores de distintas disciplinas en torno a temáticas de frontera", en este caso la bioinformática. Agrupa a numerosos grupos del CSIC, organiza actividades de formación y tiene convocatorias para financiar estancias de jóvenes investigadores en centros distintos al suyo y para que se inicien en esta disciplina. Organiza un congreso de 3 días en marzo de 2025 en Madrid.
  • El Regional Student Group en España del International Society of Computational Biology Student Council, que publica con regularidad en https://x.com/RSGSpain y en otras redes sociales (ver aquí).
  • Es posible que en tu comunidad autónoma haya alguna sociedad de bioinformática que organice eventos. Por ejemplo, en Andalucía llevan unos cuantos años organizando las Jornadas Andaluzas de Bioinformática (JABI), de las que he hablado aquí.

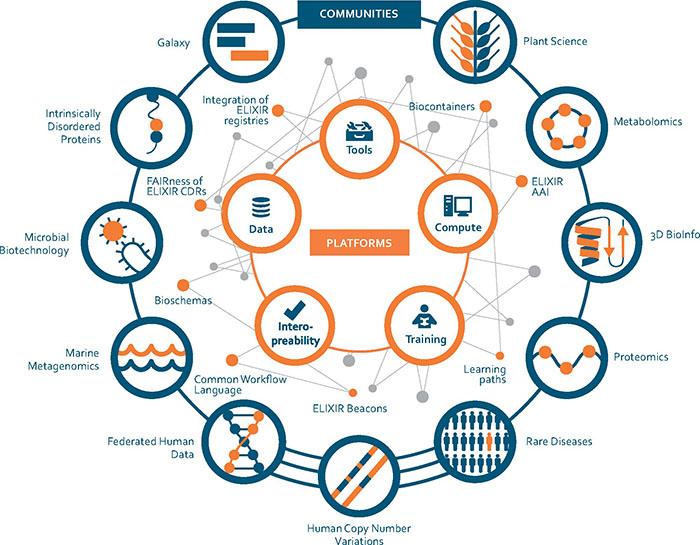
Fuente: https://elixir-europe.org/communities

18 de octubre de 2024

Algunas notas del 1er congreso de la SEBiBC

La Sociedad Española de Bioinformática y Biología Computacional (SEBiBC) celebró estos días su primer congreso bianual en Valencia y fue todo un éxito. Durante 3 días 350 estudiantes y profesionales de la biología computacional discutimos resultados recientes y fuimos iluminados por las charlas magistrales de Christine Orengo, Luz García Alonso, Doreen Ware (pionera de genómica de plantas y Gramene) y Jaime Huerta Cepas. Abajo comparto las notas de algunas de las actividades del congreso.

https://x.com/SEBiBC_es/status/1847254469093867696 


María Barranco trabaja con modelos de DL para extraer información sobre propiedades de compuestos químicos representados como SMILES como por ejemplo afinidad de union. Usan arquitectura SMILE-to-BERT y prueban dos tokenizadores distintos. Código y jupyter en https://github.com/m-baralt/smile-to-bert

Diego Herráez cuenta cómo su aproximación experimental basada en el mapeo termodinámico y la la microscopía confocal permite el estudio de células individuales en tejidos vivos, midiendo fluctuaciones (tracking- o flow-based). Figuras muy buenas, explicaciones muy superficiales por no entrar en detalles matemáticos de cómo se hace dinámica celular en 2D (no llegan todavía a 3D, es una limitación). Muestra vídeos a escala de µm de células y sus membranas. Aplican análisis de redes para modelar cómo se transmite la información en un tejido. Han estudiado el efecto de la aneuplodía en los tejidos y experimentos de migración de células.

Alejandro Orozco Valero, PhD student from UGranada, uses timeseries lib Catch22 (https://github.com/DynamicsAndNeuralSystems/catch22) to extract features from electrode-based data from two databases. Then they use DL to infer imbalances in brain activity.  He does discuss limitations and future work.

Marta Camarena talks about cancer vaccines and work recently published at https://www.science.org/doi/10.1126/sciadv.adn3628. They want to design vaccines targeting cancer-specific antigens encoded by non-canonical ORFs, mostly < 100aa, in immuneprivileged tossues (testis). Her work combines transcriptmics and immunopeptidomics. She is collaborating with clinicians at UNavarra to confirm those that elicit T cell responses. 

Christine Orengo "AlphaFold predicted structures expand our understanding of functional divergence in protein families". 

  Definen dominios sobre estructuras atómicas como consensos entre 3 métodos:

    Chainsaw para cortar dominios, incluso discontinuos, sobre matrices de contactos: https://academic.oup.com/bioinformatics/article/40/5/btae296/7667299
    Merizo: https://www.nature.com/articles/s41467-023-43934-4
    UniDoc: https://academic.oup.com/bioinformatics/article/39/2/btad070/7025502

  The encyclopedia of domains (https://zenodo.org/records/10848710), 25% are discontinuous, after filtering out poor AF models (<10%). Publicado en: https://doi.org/10.1126/science.adq4946

  Muestra resultados de PCA de CATHe (https://pubmed.ncbi.nlm.nih.gov/36648327) donde comprueba   que sus embeddings/inmersiones se parecen mucho a los HMMs de familias de CATH. En base a eso están usando https://huggingface.co/Rostlab/prot_bert para sustituir a HHalign, Prost-T5 en concreto.

Aureliano Bombarely from IBMCP starts by explaining plant features, biomass and diversity (300k species). 80% food comes from 17 families, 28k species are recorded as medicinal. Currently 2225 at NCBI Genome. Annotation tags genomic elements. Results: BRAKER > Helixer > Maker seems to incorporate better transcript (kmer) diversity and improves also over StringTie (ie BUSCO), although produces a lot of FPs (TE-related mostly). They use OrthoVenn to compare alternative annotations. DL-based Helixer is good anyway for its speed, linear with respect to assembly size, performing worse on species not used in the model.

Rubén Cañas from Global Omnium explains his work on water QC using macro-invertebrates as bioindicators, as they are responsive to env changes. Explains the Iberian BioMonitoring Water party Index and explains the scaling up methodological limitations. As a solution they try metagenomic identification of communities. They use 2 undisclosed  gene markers, combined with morpho-taxonomic identification (MI), with GM2 capturing the most diversity (shows alpha and beta diversity results). They work for family level identification. Pearson corr of metagenomic and MI is currently 0.28, but they are working on routine standardization to improve results. Discusses that NCBI Taxonomy was used for being more complete, despite other specialized resources being better for particular taxa on interests.

Michael Tress summarizes results from recently published work on novel ORFs https://academic.oup.com/nar/article/52/14/8112/7702505 . 28 out of 32 proteomics-supported examples sit in 5'UTR, and sometimes overlap with the canonical ORF. 64% human novel ORFs are not conserved beyond monkeys. Most new start codons are non canonical, most common is CTG. These ORFs are shifted towards higher %GC and are more expressed in cancer. In some cases they complete protein domains in AF models. He concludes by discussing that in most cases they add disordered regions and seem to be biological noise, except the one case that disrupts signal peptides and ships proteins to different compartments.

Arnau Montagud, currently at I2SysBio - CSIC, presents work from a postdoc at BSC. He presents their modelling software. As a disclaimer he takes some time to remind us that all models are wrong and biased, including sophisticated digital twins (DT). Despite these limitations, in healthcare multi-scale models are increasingly used to carry out animal-free pre-clinical tests. He has been using Boolean models over a decade now (MaBoss), for instance to simulate signalling pathways. Finally also mentions PhysiBoss and some current results that are being experimentally tested. He responds that quantum computing might be useful in the future.

Taller Bioinformática 2030: Innovación y Desafíos Profesionales

Diana de la Iglesia: Fujitsu tiene unidad de bioinfo, proyectos de 3-4 años que se mantienen en el tiempo, más orientados al cliente, mejores salarios

Laureano Carpio – Protoqsar advierte del suflé de la IA con la analogía de QSAR en química, recuerda el doctorado industrial, espera que con el tiempo y la mejora de las herramientas haya personas trabajando con menos cualificaciones

Sheila Zúñiga – INCLIVA habla de su experiencia en bioinfo clínica; en la SEBiBC están trabajando con el Ministerio para dar visibilidad a los profesionales bioinfo

Pedro Carmona – Centro de Investigaciones Genómicas e Oncológicas (GENYO) habla de la transformación del campo en 15 años hacia una cc de datos, actualmente tienen problemas de espacio para bioinformáticos. Cada vez más los bioinfos deberán liderar en los proyectos.

Falta la figura de técnico SO en Bioinformática para trabajar sin phd, ya ocurre en la empresa. Donde cae bioinfo en ANECA: no hay comisión específica -> comisión 0 multidisciplinar

Taller Inteligencia Artificial Generativa: El bueno, el feo y el malo

Material original: https://drive.google.com/drive/folders/1LcRG9Pi9696njoEOwpDMhJxgfkqTVJR2

Recursos: https://www.nomic.ai/gpt4all , https://asciinema.org

Ana Hernández presents her work on the Orth Group Delineation algorithm, able to detect duplication events. She did 3 benchmarks: i) Hox genes (ANTP, PRD,TALE) from 28 species, ii) quest for orthologues data and iii) using EGGNOG6 data. EGGNOG starts by doing all-vs-all comparison of sequences, which is expensive.

Alex Ascensión presents a way to detect bacterial reads, after filtering human ones, combining kraken2, krakenUniq, centrifuge and kaiku, more details at https://www.biorxiv.org/content/10.1101/2024.04.23.590754v1

Paula Ruiz presents a nextflow, dockerized pipeline for the uniform annotation of FASTA files of Mycobacterium genome assemblies with https://github.com/oschwengers/bakta and miniprot, which are then fixed using the ref annotation as guide. These improve pangenome downstream analysis.

Miguel Fernández starts by presenting ANI and its limitations, which prompted development of BACTAX-ID, code not available yet (https://github.com/irycisBioinfo/BacTaxID), which uses MASH distance and a fixed set of cutoffs to group genomes.

Taller BCBHub: Strategies for International Funding of Computational Biology and Bioinformatics
First page says it all, even 1st sentence
Repeat main idea
European leadership
Gender balance
CZF biomed,  no databases, impact, essential tools, CV weights less than tool, not for incipient tools, with community

Jaime Huerta Cepas "Functional, evolutionary and ecological signif of unknown genes in the global microbiome" summarizes ten fantastic years of work, with special focus to https://www.nature.com/articles/s41586-023-06955-z, which helped alumnus Álvaro Rodríguez del Río win the Oswaldo Trelles award for the best PhD thesis in 2024. We are proud of him and Carlos Cantalapiedra, also mentioned in the keynote.

Nuestro poster: https://digital.csic.es/handle/10261/368616


Algunos recursos que vi en pósters

Caastools para encontrar mutaciones missense en (árbol, MSA de CDS) asociadas con caracteres, ejemplo en el póster con primates: https://github.com/linudz/caastools

Protocolo para identificación y anotación de lncRNAs en plantas: https://github.com/ncRNA-lab/Cucurbit_lncRNAs_landscape

BUGSI, like BUSCO but including only housekeeping genes with only one isoform. Should be useful to estimate quality of (human?) transcriptomes. Not sure whether this would be available for plants.

Dinámica molecular para predecir mutaciones missenese que afecten al plegamiento: https://github.com/elhectro2/reMoDA

Hierarchical deep learning for predicting GO annotations: https://academic.oup.com/bioinformatics/article/38/19/4488/6656346