20 de octubre de 2026

Quiénes somos, de dónde venimos

Como la canción de Siniestro Total, que recorre algunas de las grandes preguntas sobre nuestro lugar en el universo, parece que la Bioinformática y la Biología están reubicándose en el contexto actual dominado por la IA. 

Empiezo por la columna de  Christos Ouzounis titulada Eclipse total de la bioinformática en https://doi.org/10.1371/journal.pcbi.1014287, que empieza recordando que la "Bioinformática una vez tuvo un estigma y tuvo que luchar por su legitimidad científica. Como un campo emergente, fue recibida con gran excitación pero también importantes sospechas por la mayoría de los biólogos". En este artículo el autor viene a decir que la bioinformática ya es una parte central de la Biología, tan central que igual ya no tiene sentido seguir usando la etiqueta Bioinformática. Añade, parafraseando a Dobzhansky, que nada en Biología tiene sentido ya excepto a la luz de la computación. No sé si exagera, pero por poner algo de mi cosecha le he preguntado a https://consensus.app y confirma en parte estas afirmaciones citando varios trabajos, entre ellos al propio Ouzounis, mencionando la vieja discusión de si es un servicio o una disciplina autónoma. 


Sigo con la reflexión de Ran Blekhman, autor nuevo para mi, titulada Para qué sirve la investigación en biología, en https://doi.org/10.1371/journal.pbio.3004075. La idea central del autor es dado lo tremendamente fácil que es ya hacer artículos con ayuda de la IA, contar artículos como medida de producción científica ya no tendrá valor alguno. Va más allá, dice que corremos el riesgo de volver al factor de impacto como valor refugio, dejando en papel mojado iniciativas como la San Francisco Declaration on Research Assessment o el manifiesto de Leiden. 

Tengo curiosidad por ver qué dice sobre estos temas Alfonso Valencia, ganador del Premio Nacional Bioinformática y Biología Computacional, en el congreso de la SEBiBC en unas semanas.

Un saludo, Bruno

11 de septiembre de 2026

RSAT Plants requires registration for now

Hi, some readers of the blog are users of our Web app RSAT Plants, which has been covered before, for instance here. This post is for them.

For security reasons access to https://rsat.eead.csic.es/plants (http://plants.rsat.eu) requires registration for now. You will need to request a password by email to compbio at eead.csic.es justifying why you need access to the tools for your research. You should then be able to login with username & password. When you open the URL you will see a simple login dialog:


Once you get it in is business as usual, you'll notice that email has been disabled to.

Take care 

PS this message is duplicated at https://github.com/eead-csic-compbio/RSAT-Plants-registration


11 de agosto de 2026

Barleymap graph release

Barleymap (https://barleymap.eead.csic.es/barleymap), a Web tool for mapping the position of genetic markers along maps of the barley genome, has been updated and now it supports graph searches over the Pan20 barley pangenome. 

The Graph feature has actually been available for a couple months now, but today the preprint describing its development and testing came out at https://www.biorxiv.org/content/10.64898/2026.08.06.741139v1 . I'll paste here the abstract:

"Barley (Hordeum vulgare) is a key cereal crop with exceptional adaptation to diverse  environments. With a large, highly repetitive diploid genome, barley presents challenges for pangenome representation. Starting from the reference genome MorexV3, we describe the construction of a barley graph (Pan20) representing the global diversity of landraces and cultivars captured in the public pangenome V1. For mapping arbitrary sequences, a greedy strategy is proposed that combines GMAP alignment followed by intersection with a Practical Haplotype Graph (PHG). This enables presence-absence variation detection and provides a consistent MorexV3 physical coordinate system across genotypes, enabling comparative analysis and visualization. For imputation of genomic data, the PHG approach relies on k-mer pseudo-alignment against the graph. Benchmarks show that Pan20 can accurately align barley genomic and transcriptomic sequences, including those not present in the Morex reference, revealing that a third of long genomic sequences map on non-reference genomes. Moreover, experiments with Genotyping by Sequencing and low-pass sequencing data indicate that FASTQ files can be efficiently mapped and imputed against the graph, preserving local haplotype context. This flexible and scalable graph framework allows barley researchers to explore genetic diversity beyond a single reference and facilitates analysis of diversity panels at the haplotype level, going beyond SNPs. Documentation and a Docker container are available at https://github.com/eead-csic-compbio/barleygraph. The graph sequence mapping utility was added to the Web application https://barleymap.eead.csic.es ." 

Please give it a go and let us know if it works for you, or not. I am posting this from my summer break, and Joan Sàrria is also away, so we might take a while to respond to issues or comments.

Pan20 summary 


Take care, Bruno

31 de julio de 2026

Pruebo minibwa

Seguro que mapeáis lecturas cortas tipo Illumina como parte de vuestra labor. Si es el caso, entonces conoceréis las herramientas ya clásicas bwa-mem y minimap2, de las que hemos hablado antes (1, 2), desarrolladas por el prolífico Heng Li. 

BWA mem se publicó en 2013 destacando su rendimiento al alinear secuencias en torno a los 100b, como las lecturas cortas. Para ser más preciso, nunca se publicó en una revista al ser rechazado, y a día de hoy su preimpresión supera ya las 14K citas, lo que demuestra su utilidad. En cambio, minimap2 alinea con precisión secuencias mucho más largas, como las lecturas HiFi de Pacbio u ONT, o incluso cromosomas enteros. Se publicó en 2018. Como se puede ver en el panel derecho de la Figura 1, ambos algoritmos comparten ideas y componentes y han servido para inspirar otros como bwa-mem2. 


Imagen
Figura 1. minibwa comparado con otros mapeadores. Fuente: https://x.com/lh3lh3/status/2066917108932329924

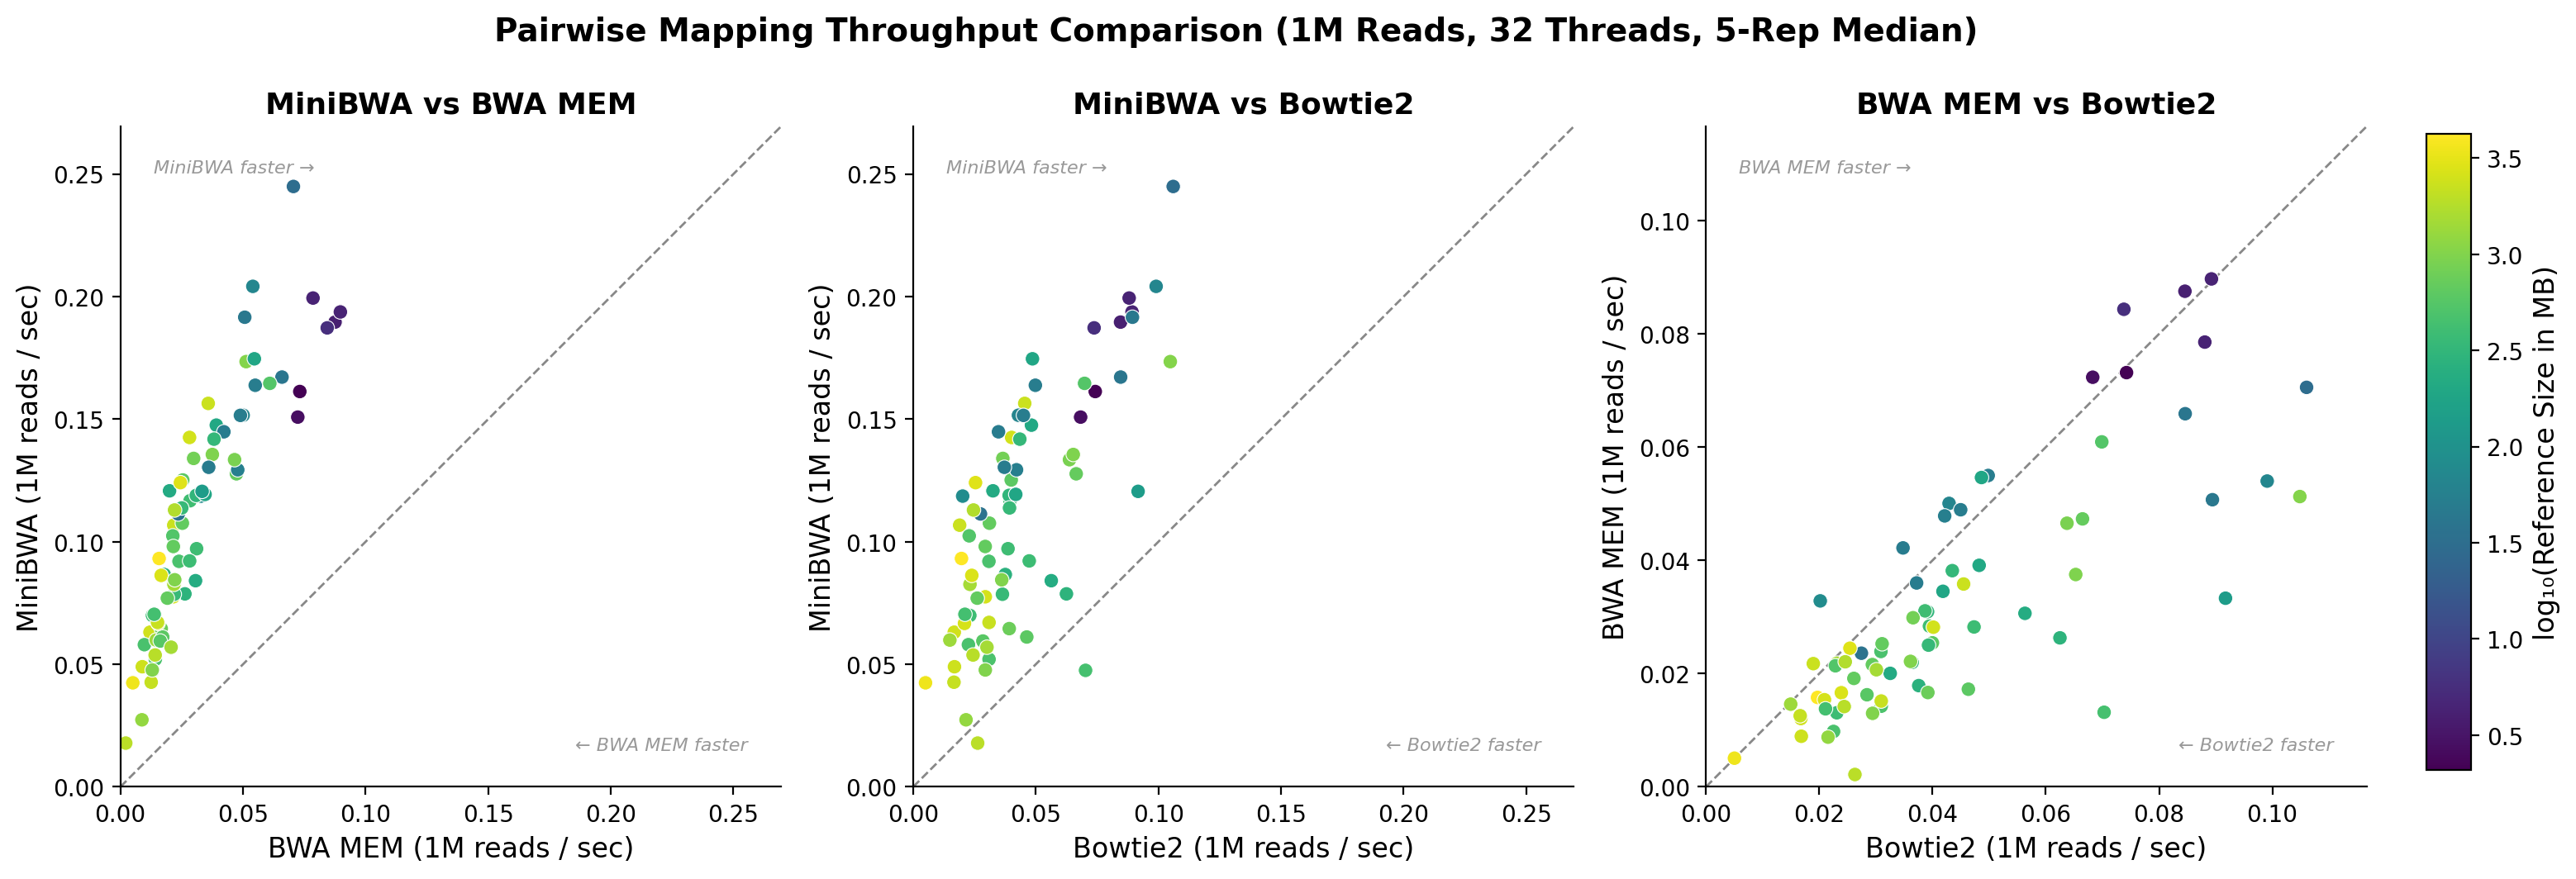
El mes pasado el autor liberó minibwa, que en sus propias palabras reemplaza a bwa-mem y soporta de manera nativa datos de tipo BS-seq. Podéis ver los detalles de su validación en arxiv, o en éste otro blog, pero en resumen es un algoritmo nuevo que supero limitaciones de diseño de bwa-mem tomando prestadas ideas de minimap2, que además es varias veces más rápido que el primero produciendo resultados muy similares con lecturas cortas. Además, como se ve en la Figura 1 consume mucha menos RAM. En la Figura 2 se muestra que es también mucho más rápido que Bowtie2, otro mapeador muy popular.

Mapping throughput comparison of MiniBWA, BWA MEM, and Bowtie2
Figura 2. Rendimiento de mapeo de minibwa, bwa-mem y Bowtie2, donce cada punto es un fichero de lecturas cortas de una especie diferente. Fuente: https://andrewcarroll.github.io/2026/06/30/the-best-of-both-worlds-assessing-minibwa.html


En mis propias pruebas con cebada (4GB) con las versiones bwa-mem 0.7.16a y minibwa 0.6-r416 he observado además:

  •  El nuevo índice tarda menos en calcularse (minibwa index), supongo que en parte porque se puede paralelizar con varios hilos. Real time: 1633.288 sec; CPU: 2090.351 sec; Peak RSS: 74.990 GB
  • El nuevo índice son solamente dos ficheros (.lb2 y .mbw) que en total pesan más (8.9GB) que el índice antiguo (7G).
  • Si usas parámetros por defecto puedes cambiar fácilmente un programa por el otro en tus scripts.

El código está disponible en https://github.com/lh3/minibwa,

hasta pronto, Bruno


9 de junio de 2026

Comprime y consulta ficheros FASTA con agc

Hola,  hoy voy a escribir sobre el software AGC (Assembled Genomes Compressor), escrito en C++, que sirve para comprimir ensamblajes genómicos en múltiples ficheros FASTA (un pangenoma) y luego extraer de manera eficiente secuencias de nucleótidos arbitrarias o contigs completos. El artículo que lo describe está en https://doi.org/10.1093/bioinformatics/btad097 y el código en https://github.com/refresh-bio/agc. 

AGC comprime los ensamblajes/ficheros FASTA en varias etapas usando por defecto k=31:

Principales etapas de la compresión: (a) selección de k-meros distribuidos de manera uniforme en genoma de referencia cada 60Kb, splitters;  (b)  compresión del genoma de referencia tras partirlo en grupos y segmentos; (c y d)  compresión del resto de genomas. Los segmentos flanqueados por los mismos splitters se comprimen juntos; los de referencia con zstd y los demás con LZSS para marcar las diferencias respecto al de referencia correspondiente para comprimir solamente esas partes con zstd. Figura tomada de https://doi.org/10.1093/bioinformatics/btad097

En nuestro caso, probamos AGC con 20 genomas de cebada del pangenoma V2, cada uno de unos 4GB, obteniendo una estructura de datos comprimida de 3.4GB con el siguiente comando:

$ agc create <ref.fa> <genoma2.fa> ... <genoma20.fa> assemblies.agc

# nota: se pueden añadir nuevos genomas más tarde con agc append 

Comprobamos el contenido del archivo comprimido:

$ agc listset assemblies.agc
Akashinriki
B1K-04-12
Barke
Chiba
Du_Li_Huang
GoldenPromise
HOR_10350
HOR_13821
HOR_13942
HOR_21599
HOR_3081
HOR_3365
HOR_7552
HOR_8148
HOR_9043
Hockett
Igri
MorexV3
OUN333
Planet


Finalmente, lo más interesante, podemos obtener secuencias de interés por medio de sus coordenadas:

$ agc getctg assemblies.agc chr1H@Barke:1-20 

>chr1H sampleName=Barke:1-20
ATGCTATTAGTCACTAATTT

Toda la documentación y más ejemplos están en https://github.com/refresh-bio/agc, que lo disfrutéis,

Bruno