Mostrando entradas con la etiqueta alineamiento. Mostrar todas las entradas

31 de julio de 2026

Pruebo minibwa

Seguro que mapeáis lecturas cortas tipo Illumina como parte de vuestra labor. Si es el caso, entonces conoceréis las herramientas ya clásicas bwa-mem y minimap2, de las que hemos hablado antes (1, 2), desarrolladas por el prolífico Heng Li

BWA mem se publicó en 2013 destacando su rendimiento al alinear secuencias en torno a los 100b, como las lecturas cortas. Para ser más preciso, nunca se publicó en una revista al ser rechazado, y a día de hoy su preimpresión supera ya las 14K citas, lo que demuestra su utilidad. En cambio, minimap2 alinea con precisión secuencias mucho más largas, como las lecturas HiFi de Pacbio u ONT, o incluso cromosomas enteros. Se publicó en 2018. Como se puede ver en el panel derecho de la Figura 1, ambos algoritmos comparten ideas y componentes y han servido para inspirar otros como bwa-mem2


Imagen
Figura 1. minibwa comparado con otros mapeadores. Fuente: https://x.com/lh3lh3/status/2066917108932329924

El mes pasado el autor liberó minibwa, que en sus propias palabras reemplaza a bwa-mem y soporta de manera nativa datos de tipo BS-seq. Podéis ver los detalles de su validación en arxiv, o en éste otro blog, pero en resumen es un algoritmo nuevo que supero limitaciones de diseño de bwa-mem tomando prestadas ideas de minimap2, que además es varias veces más rápido que el primero produciendo resultados muy similares con lecturas cortas. Además, como se ve en la Figura 1 consume mucha menos RAM. En la Figura 2 se muestra que es también mucho más rápido que Bowtie2, otro mapeador muy popular.
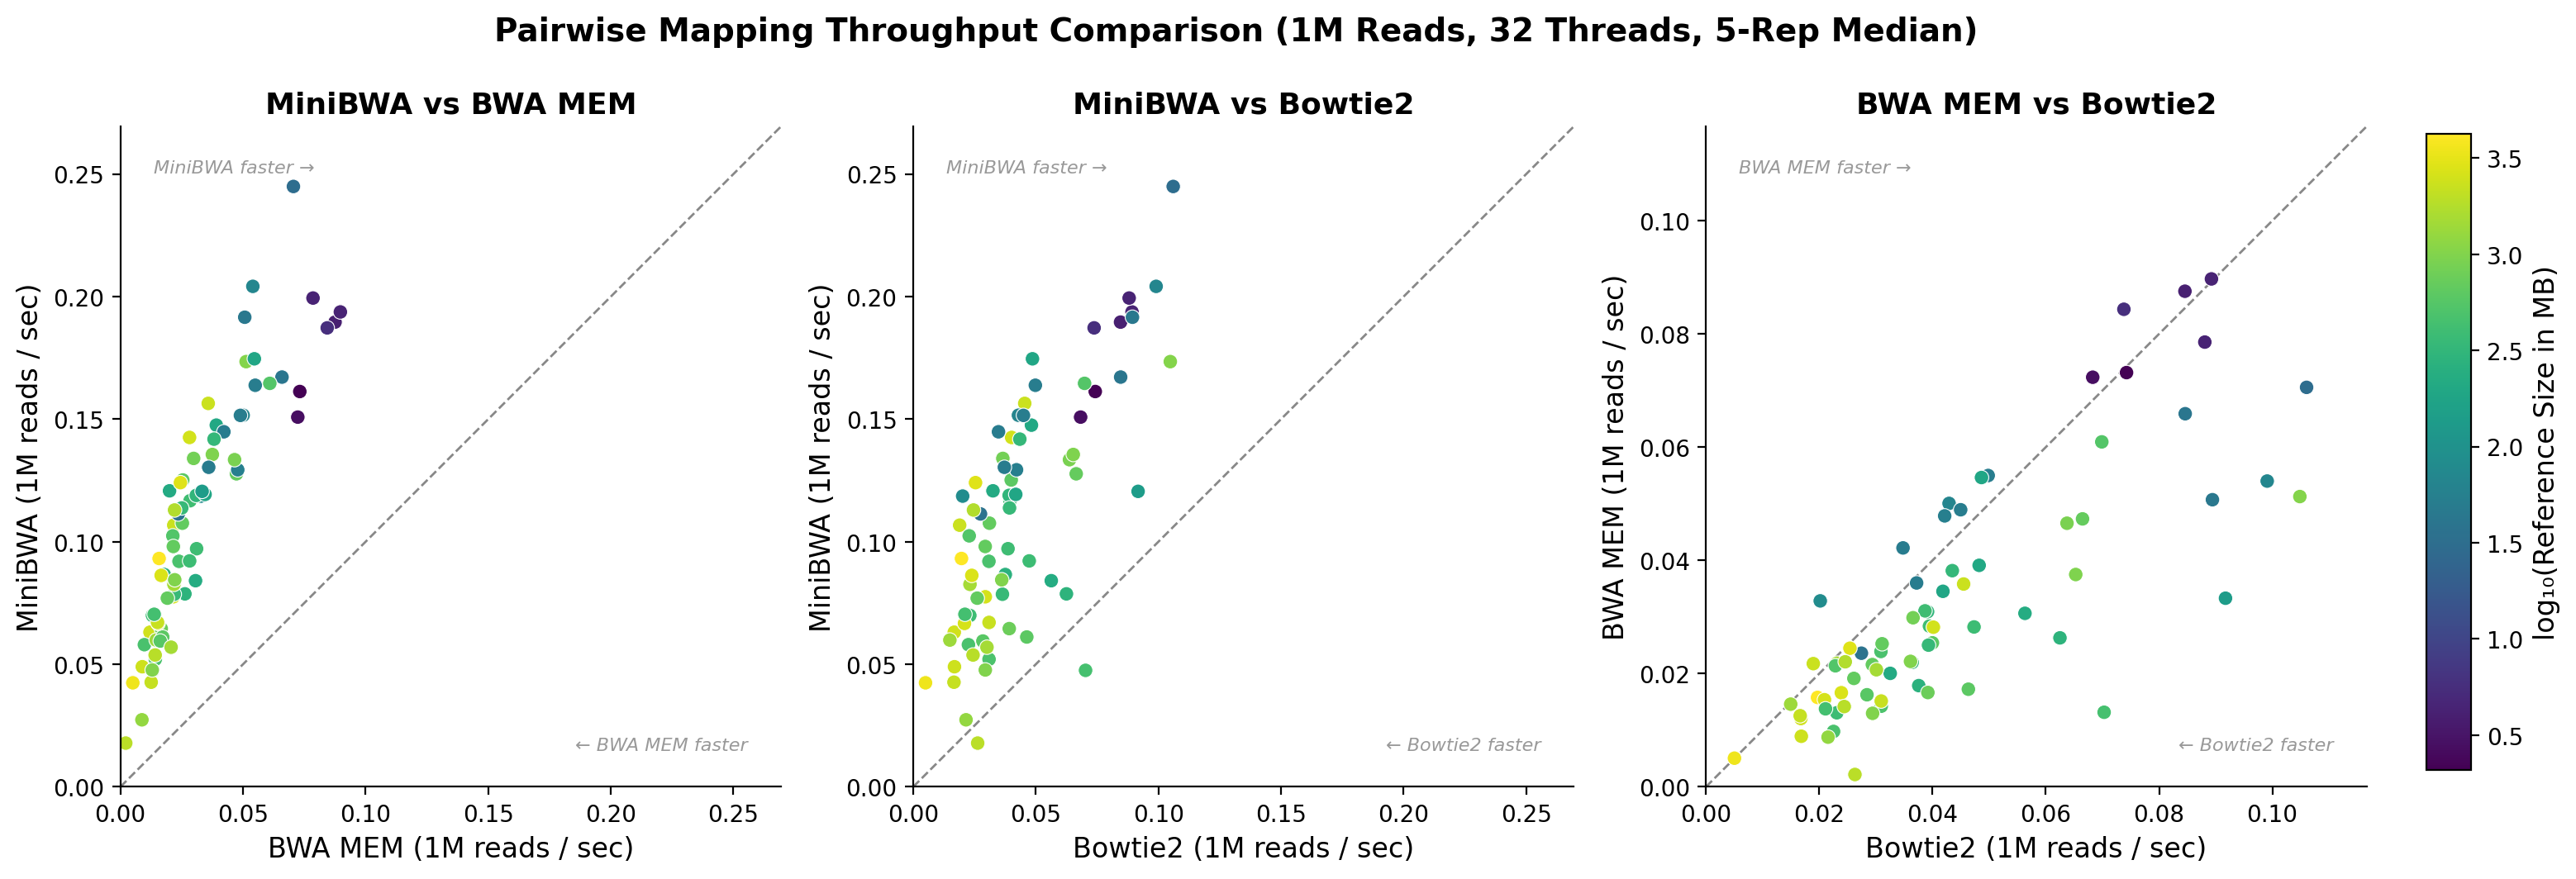
Mapping throughput comparison of MiniBWA, BWA MEM, and Bowtie2
Figura 2. Rendimiento de mapeo de minibwa, bwa-mem y Bowtie2, donce cada punto es un fichero de lecturas cortas de una especie diferente. Fuente: https://andrewcarroll.github.io/2026/06/30/the-best-of-both-worlds-assessing-minibwa.html


En mis propias pruebas con cebada (4GB) con las versiones bwa-mem 0.7.16a y minibwa 0.6-r416 he observado además:

  •  El nuevo índice tarda menos en calcularse (minibwa index), supongo que en parte porque se puede paralelizar con varios hilos. Real time: 1633.288 sec; CPU: 2090.351 sec; Peak RSS: 74.990 GB
  • El nuevo índice son solamente dos ficheros (.lb2 y .mbw) que en total pesan más (8.9GB) que el índice antiguo (7G).
  • Si usas parámetros por defecto puedes cambiar fácilmente un programa por el otro en tus scripts.

El código está disponible en https://github.com/lh3/minibwa,

hasta pronto, Bruno


14 de octubre de 2024

premio Nobel en diseño y predicción de estructuras de proteínas

La semana pasada anunciaron el premio Nobel de química de 2024:

  • 1/2 a David Baker, “for computational protein design”
  • 1/2 a Demis Hassabis y John M. Jumper “for protein structure prediction”

O como se ve en la figura, por jugar con proteínas en 3D:

https://www.nobelprize.org/prizes/chemistry/2024/press-release


Lo celebro en el blog porque hemos sido lectores de sus trabajos, usuarios de sus herramientas y divulgadores de sus avances desde hace años. Por temática, este premio sigue seguramente a éste otro. Hay muchas cosas que comentar de este premio, iré por partes. Si no conocéis el campo podéis revisar el material que durante años he ido revisando en http://eead-csic-compbio.github.io/bioinformatica_estructural .

En primer lugar, el grupo de David Baker ha sido un héroe del experimento CASP desde hace décadas y ya en 2011 le ponía como candidato a este premio. En la edición de 2003 (CASP5), en la que participé como parte de mi tesis, ya fueron los mejores en la categoría de nuevos plegamientos con el software Rosetta, por entonces escrito en FORTRAN. Para mi ha sido increíble ver cómo su grupo ha estado al frente todos estos años, incluso cuando AlphaFold (AF) les superó, ya en CASP13 y CASP14. A pesar de ello, nadie les ha superado diseñando proteínas y comprobando experimentalmente, por cristalografía y NMR, que funcionaban como esperaban. La suya ha sido sin duda una larga y exitosa carrera, de la que podéis leer más en inglés por ejemplo en el resumen de la Academia Sueca o en su lista de publicaciones.

En segundo lugar, el premio se centra en el trabajo que llevó a producir el predictor AF2, del que hemos hablado largo y tendido en este blog, por ejemplo en la reciente entrada sobre un protocolo para modelar parejas de proteínas. En este caso los ganadores son fundadores y empleados de deepmind.google. A diferencia de David Baker llevan poco tiempo trabajando este área, pero han sabido mirar a hombros de gigantes de una manera muy eficiente, aprovechando lo aprendido por la comunidad CASP, la creciente colección de estructuras de alta calidad disponibles en el Protein Data Bank y las inabarcables bases de datos de secuencias naturales. Sin duda éste es un ejemplo más de un gran logro científico obtenido como resultado de muchos proyectos de ciencia básica y abierta, de la que Demis Hassabis es defensor, como nosotros en el blog. Es una pena que la versión AF3, que da menos peso a las secuencias naturales, no sea de momento de acceso abierto, algo que ha generado mucha polémica.

Hasta pronto,

Bruno

PD Si os gustan los hilos de Twitter podéis ver éste desde la perspectiva de Ewan Birney