Mostrando entradas con la etiqueta minimap2. Mostrar todas las entradas

11 de agosto de 2026

Barleymap graph release

Barleymap (https://barleymap.eead.csic.es/barleymap), a Web tool for mapping the position of genetic markers along maps of the barley genome, has been updated and now it supports graph searches over the Pan20 barley pangenome. 

The Graph feature has actually been available for a couple months now, but today the preprint describing its development and testing came out at https://www.biorxiv.org/content/10.64898/2026.08.06.741139v1 . I'll paste here the abstract:

"Barley (Hordeum vulgare) is a key cereal crop with exceptional adaptation to diverse  environments. With a large, highly repetitive diploid genome, barley presents challenges for pangenome representation. Starting from the reference genome MorexV3, we describe the construction of a barley graph (Pan20) representing the global diversity of landraces and cultivars captured in the public pangenome V1. For mapping arbitrary sequences, a greedy strategy is proposed that combines GMAP alignment followed by intersection with a Practical Haplotype Graph (PHG). This enables presence-absence variation detection and provides a consistent MorexV3 physical coordinate system across genotypes, enabling comparative analysis and visualization. For imputation of genomic data, the PHG approach relies on k-mer pseudo-alignment against the graph. Benchmarks show that Pan20 can accurately align barley genomic and transcriptomic sequences, including those not present in the Morex reference, revealing that a third of long genomic sequences map on non-reference genomes. Moreover, experiments with Genotyping by Sequencing and low-pass sequencing data indicate that FASTQ files can be efficiently mapped and imputed against the graph, preserving local haplotype context. This flexible and scalable graph framework allows barley researchers to explore genetic diversity beyond a single reference and facilitates analysis of diversity panels at the haplotype level, going beyond SNPs. Documentation and a Docker container are available at https://github.com/eead-csic-compbio/barleygraph. The graph sequence mapping utility was added to the Web application https://barleymap.eead.csic.es ." 

Please give it a go and let us know if it works for you, or not. I am posting this from my summer break, and Joan Sàrria is also away, so we might take a while to respond to issues or comments.

Pan20 summary 


Take care, Bruno

31 de julio de 2026

Pruebo minibwa

Seguro que mapeáis lecturas cortas tipo Illumina como parte de vuestra labor. Si es el caso, entonces conoceréis las herramientas ya clásicas bwa-mem y minimap2, de las que hemos hablado antes (1, 2), desarrolladas por el prolífico Heng Li. 

BWA mem se publicó en 2013 destacando su rendimiento al alinear secuencias en torno a los 100b, como las lecturas cortas. Para ser más preciso, nunca se publicó en una revista al ser rechazado, y a día de hoy su preimpresión supera ya las 14K citas, lo que demuestra su utilidad. En cambio, minimap2 alinea con precisión secuencias mucho más largas, como las lecturas HiFi de Pacbio u ONT, o incluso cromosomas enteros. Se publicó en 2018. Como se puede ver en el panel derecho de la Figura 1, ambos algoritmos comparten ideas y componentes y han servido para inspirar otros como bwa-mem2. 


Imagen
Figura 1. minibwa comparado con otros mapeadores. Fuente: https://x.com/lh3lh3/status/2066917108932329924

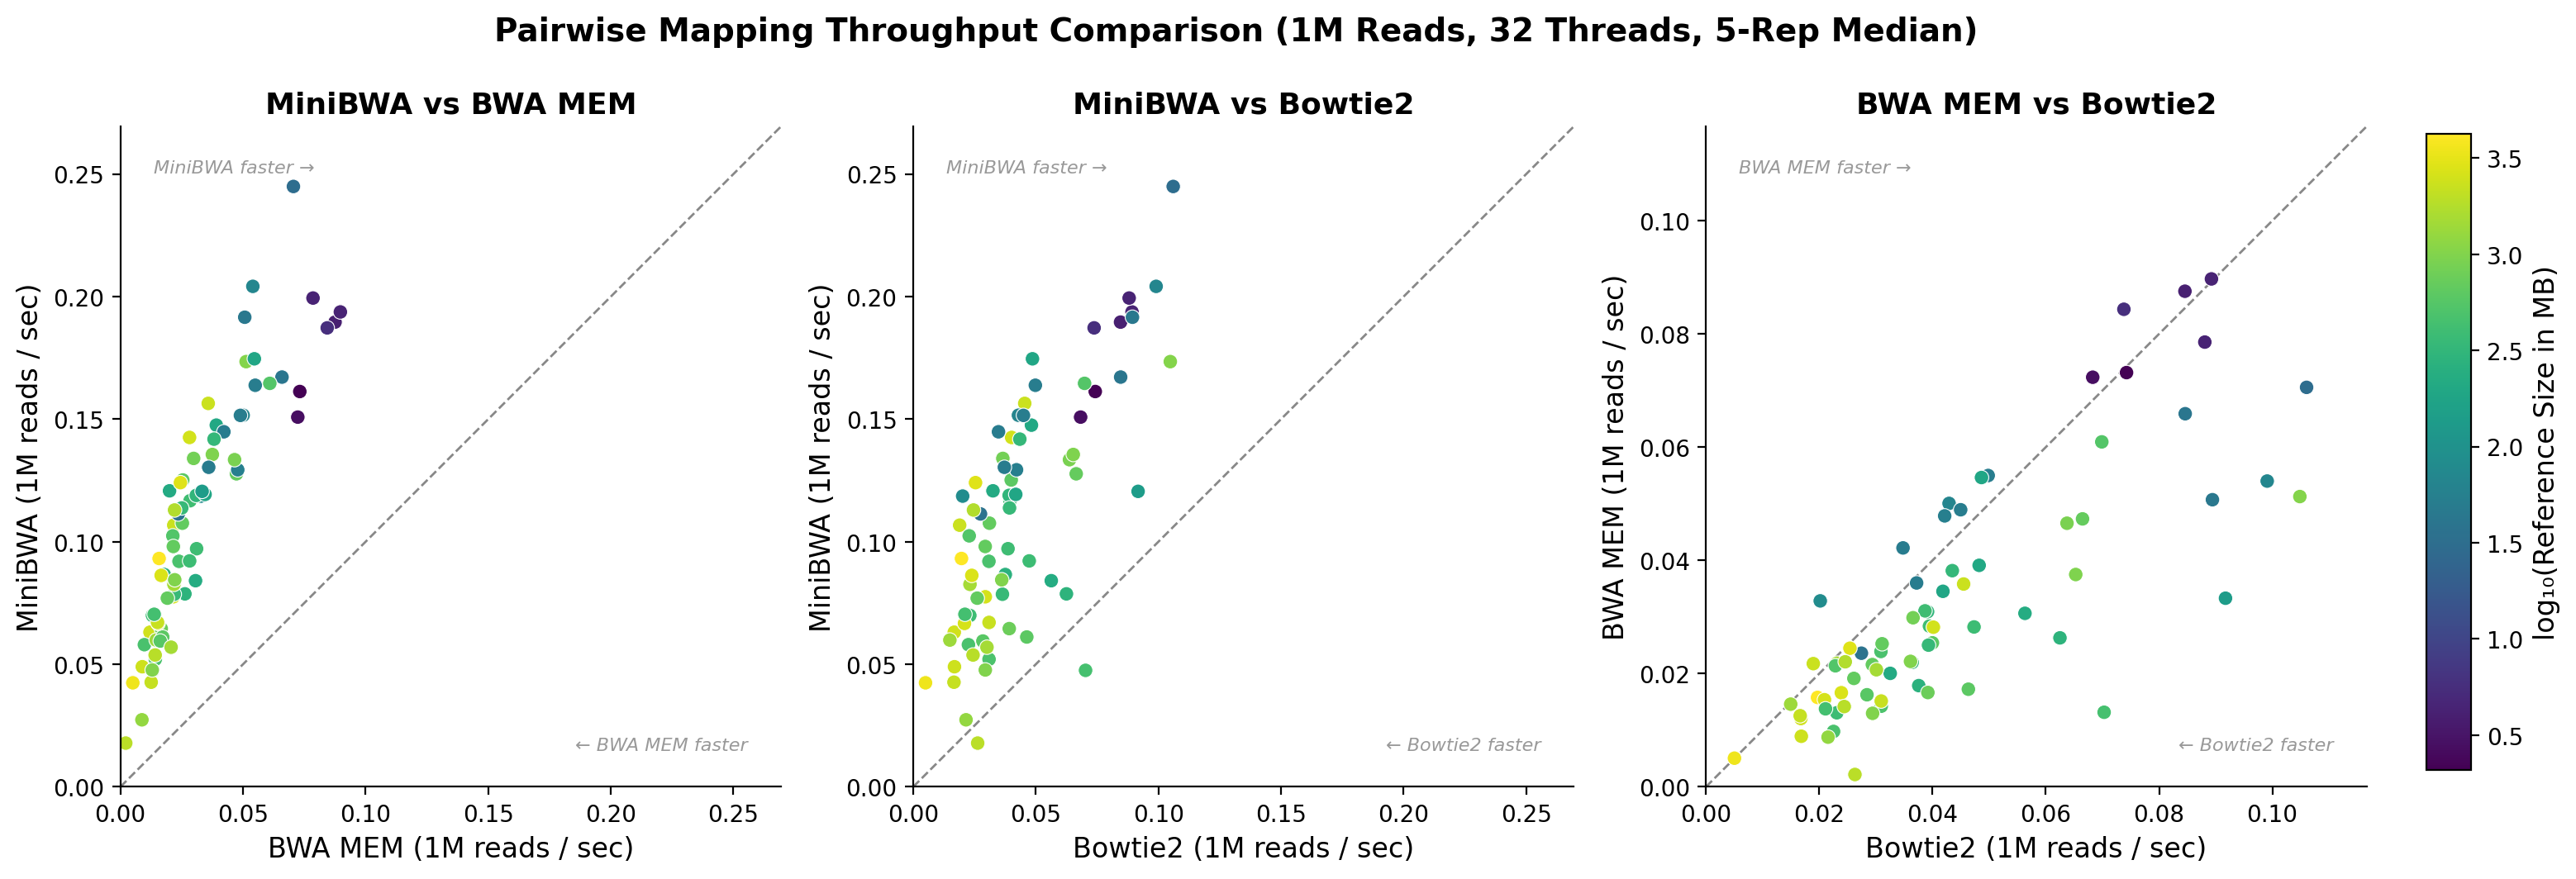
El mes pasado el autor liberó minibwa, que en sus propias palabras reemplaza a bwa-mem y soporta de manera nativa datos de tipo BS-seq. Podéis ver los detalles de su validación en arxiv, o en éste otro blog, pero en resumen es un algoritmo nuevo que supero limitaciones de diseño de bwa-mem tomando prestadas ideas de minimap2, que además es varias veces más rápido que el primero produciendo resultados muy similares con lecturas cortas. Además, como se ve en la Figura 1 consume mucha menos RAM. En la Figura 2 se muestra que es también mucho más rápido que Bowtie2, otro mapeador muy popular.

Mapping throughput comparison of MiniBWA, BWA MEM, and Bowtie2
Figura 2. Rendimiento de mapeo de minibwa, bwa-mem y Bowtie2, donce cada punto es un fichero de lecturas cortas de una especie diferente. Fuente: https://andrewcarroll.github.io/2026/06/30/the-best-of-both-worlds-assessing-minibwa.html


En mis propias pruebas con cebada (4GB) con las versiones bwa-mem 0.7.16a y minibwa 0.6-r416 he observado además:

  •  El nuevo índice tarda menos en calcularse (minibwa index), supongo que en parte porque se puede paralelizar con varios hilos. Real time: 1633.288 sec; CPU: 2090.351 sec; Peak RSS: 74.990 GB
  • El nuevo índice son solamente dos ficheros (.lb2 y .mbw) que en total pesan más (8.9GB) que el índice antiguo (7G).
  • Si usas parámetros por defecto puedes cambiar fácilmente un programa por el otro en tus scripts.

El código está disponible en https://github.com/lh3/minibwa,

hasta pronto, Bruno


26 de septiembre de 2022

Probamos miniprot para mapear proteínas sobre genomas

Hola, 

hoy escribo a mi regreso del X Congreso Nacional de Mejora Genética de Plantas, donde se habló y mucho de herramientas de genómica computacional.

Justo esos días me enteré de la liberación de las primeras versiones de miniprot, un programa de Heng Li, el creador de minimap, del que ya hablamos aquí comparándolo con BLASTN. 

Esto me recordó que hace unos años, mientras Carlos Cantalapiedra empezaba a desarrollar BARLEYMAP, nos preguntamos qué programas había disponibles para mapear secuencias de genes, tránscritos y proteínas sobre genomas. Para los dos primeros tipos de secuencias encontramos GMAP, que adoptamos para nuestro nuevo software, pero para el tercero no encontramos ninguno que nos gustara del todo más allá de BLASTX y spaln. Justo para eso es miniprot. Lo he probado con una proteína de cebada:

#installation
git clone https://github.com/lh3/miniprot.git
cd miniprot/
make

# index barley genome
./miniprot -t 8 -d GCA_904849725.1_MorexV3.mpi GCA_904849725.1_MorexV3.fna

# example: map protein HORVU3Hr1G095240
./miniprot --gff GCA_904849725.1_MorexV3.fna HvOs2/HORVU3Hr1G095240.pep.fa


Cómo veis pedí la salida en formato GFF y me la ha devuelto precedida del mismo resultado en formato PAF, que incluye CIGARs y en la columna 10 el número nucleótidos alineados (477 en el ejemplo) y :

##gff-version 3
##PAF	transcript:HORVU3Hr1G095240.2	159	0	159	...
chr3H_LR890098.1	miniprot	mRNA	577160564	577200549	...
chr3H_LR890098.1	miniprot	CDS	577200365	577200549	...
chr3H_LR890098.1	miniprot	CDS	577162212	577162293	...
chr3H_LR890098.1	miniprot	CDS	577161755	577161804	...
chr3H_LR890098.1	miniprot	CDS	577161575	577161671	...
chr3H_LR890098.1	miniprot	CDS	577160567	577160629	...
chr3H_LR890098.1	miniprot	stop_codon	577160564	577160566	...

Lo que coincide con los resultados de BARLEYMAP cuando busco la secuencia de nucleótidos (CDS) correspondiente:

HORVU3Hr1G095240.2	chr3H_LR890098.1 577160564 577200549


El manual está en https://lh3.github.io/miniprot/miniprot.html , si encontráis errores podéis comunicarlos en https://github.com/lh3/miniprot/issues


Hasta pronto,

Bruno

19 de febrero de 2021

mapeando genes con liftoff

Hola,

esta semana en Ensembl tuvimos que probar a mapear genes de un ensamblaje genómico de arroz sobre otro ensamblaje más reciente. Esto se llama lift-over en la literatura. Para ello probamos un software que se llama Liftoff, publicado en Bioinformatics, con código fuente en https://github.com/agshumate/Liftoff

Como resume la figura para el tránscrito humano ENST00000598723.5, Liftoff calcula por medio de minimap2 alineamientos parciales al genoma de referencia y luego calcula el grafo más corto que conecte los alineamientos:


Resumo ahora cómo instalé este software escrito en python y cómo lo probé.


## pyenv 

# set up a pyenv folder
export PYENV_ROOT="$HOME/.pyenv"
 
curl https://pyenv.run | bash
 
pyenv install 3.7.9
 
# create dedicated env
pyenv virtualenv 3.7.9 liftoff

# install Liftoff inside that environment
pyenv shell 3.7.9 liftoff
pip install --upgrade pip
pip install Liftoff

# add the following to your .bashrc:
export PATH="$PYENV_ROOT/bin:$PATH"
eval "$(pyenv init -)"
eval "$(pyenv virtualenv-init -)"

## Test run:

pyenv shell 3.7.9 liftoff
liftoff -g old.gff3 -o old.new.liftoff.gff -p 4 new.genome.fna old.genome.fasta


El fichero de salida es un GFF con contenido como éste:

1       Liftoff gene    2903    10817   .       +       .       ID=LOC_Os01g01010;Name=LOC_Os01g01010;Note=TBC domain containing protein, expressed;coverage=1.0;sequence_ID=1.0;extra_copy_number=0;copy_num_ID=LOC_Os01g01010_0
1       Liftoff mRNA    2903    10817   .       +       .       ID=LOC_Os01g01010.1;Name=LOC_Os01g01010.1;Parent=LOC_Os01g01010;extra_copy_number=0
1       Liftoff exon    2903    3268    .       +       .       ID=LOC_Os01g01010.1:exon_1;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    3354    3616    .       +       .       ID=LOC_Os01g01010.1:exon_2;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    4357    4455    .       +       .       ID=LOC_Os01g01010.1:exon_3;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    5457    5560    .       +       .       ID=LOC_Os01g01010.1:exon_4;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    7136    7944    .       +       .       ID=LOC_Os01g01010.1:exon_5;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    8028    8150    .       +       .       ID=LOC_Os01g01010.1:exon_6;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    8232    8320    .       +       .       ID=LOC_Os01g01010.1:exon_7;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    8408    8608    .       +       .       ID=LOC_Os01g01010.1:exon_8;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    9210    9617    .       +       .       ID=LOC_Os01g01010.1:exon_9;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    10104   10187   .       +       .       ID=LOC_Os01g01010.1:exon_10;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    10274   10430   .       +       .       ID=LOC_Os01g01010.1:exon_11;Parent=LOC_Os01g01010.1;extra_copy_number=0
1       Liftoff exon    10504   10817   .       +       .       ID=LOC_Os01g01010.1:exon_12;Parent=LOC_Os01g01010.1;extra_copy_number=0

Hasta pronto, 

Bruno

12 de septiembre de 2020

Alineamiento global con el algoritmo Wavefront (WFA)

Hola, en esta entrada vuelvo a una de las piedras angulares de la biología computacional, el alineamiento de secuencias. Este problema tiene múltiples caras, algunas ya discutidas en este blog, pero desde el algoritmo de Needleman-Wunsch su formulación fundamental es el alineamiento global de dos secuencias q y t de longitudes n y m, desde el principio hasta el final. 

La última vuelta de tuerca la acaban de publicar Santiago Marco Sola y colaboradores en Bioinformatics, donde describen su algoritmo de alineamiento llamado wavefront (WFA). En el artículo los autores muestran como WFA y su variante heurística WFA-Adapt son más eficientes tanto en tiempo de cálculo como en consumo de memoria que las alternativas del estado del arte, incluyendo los algoritmos de la librería KSW2, empleada por  minimap2 (visto en este blog).

Recomiendo la lectura del artículo porque es muy didáctico y está escrito en un estilo sencillo, dada la naturaleza del problema. A continuación resumo aquí las ideas principales. 

El problema que resuelve WFA es un alineamiento global entre dos secuencias usando el modelo affine-gap como función coste. Esto significa que para cada par de posiciones alineadas el coste del alineamiento aumenta en 0 puntos en caso de ser idénticas (a), en x puntos en caso de ser diferentes (x=6 en BWA-MEM) o con un coste lineal para las inserciones que se calcula como g(n) = o + e n  donde o es el coste de abrir un indel y e el de extenderlo n bases. WFA es un algoritmo exacto que calcula el alineamiento óptimo como aquel que termina en la celda (n,m) de la matriz de programación dinámica (Figura 1, izquierda) con un coste total más pequeño. Hasta aquí nada nuevo, es un algoritmo que busca diagonales que alinean las dos secuencias.

La novedad de WFA es que define furthest-reaching points (fr), vectores  Fs,k que indican para una diagonal k el punto más lejano donde se alcanza un coste s (ver Figura 1 izquierda, vectores M0, M4 y M8 desde el origen, donde M=matches, de la misms manera que I=indel y D=deletion). En su algoritmo reformulan el alineamiento por programación dinámica calculando vectores fr para un coste s en base a los vectores fr calculados para costes menores, pero de manera que sólo una fracción de los fr se llegan a calcular. El algoritmo descrito en la Figura 2 recibe su nombre porque para cada coste s se define el frente de onda WFs como el conjunto de todos los vectores fr con coste total s. El alineamiento optimo se corresponde a la secuencia de frentes de onda desde WF0 a WFs que alcanzan la coordenada (n, m) con el menor coste s. En el ejemplo de la Figura 1 solamente es necesario guardar en memoria 3 WF (0, 4 y 8) para calcular el alineamiento óptimo y luego reconstruirlo. A diferencia de otros algoritmos de alineamiento, WFA es más eficiente cuánto más se parecen las secuencias a alinear y sus operaciones son fácilmente paralelizables de manera portable con instrucciones SIMD.

 
Figura 1. Alineamiento global de dos secuencias en una matriz de programación dinámica (izq) y su representación en forma de vectores fr (furthest-reaching points, dcha). En la matriz las celdas (0,0) y (6,6) marcan respectivamente el principio y el final del alineamiento. Tomada de Bioinformatics. 


Figura 2. Pseudocódigo para el algoritmo WFA, tomado de Bioinformatics.

Para terminar esta entrada, el código de WFA está escrito en C y se compila fácilmente con gcc si lo clonas desde el repositorio https://github.com/smarco/WFA . Allí encontrarás ejemplos sencillos de cómo llamar a las funciones de alineamiento, un saludo,

Bruno